Block Storage là một trong những phương thức lưu trữ thường được sử dụng cho các workload cần truy cập dữ liệu ở cấp block và có yêu cầu cụ thể về hiệu năng I/O, độ trễ hoặc khả năng mở rộng. Mô hình này đặc biệt phù hợp với môi trường Cloud, ảo hóa và các hệ thống ứng dụng doanh nghiệp cần lưu trữ ổn định, linh hoạt theo nhu cầu vận hành.
Vậy Block Storage hoạt động như thế nào, phù hợp với những workload nào và khác biệt ra sao so với File Storage hay Object Storage? Việc hiểu rõ đặc điểm của Block Storage sẽ giúp doanh nghiệp lựa chọn mô hình lưu trữ phù hợp với yêu cầu kỹ thuật và kiến trúc hệ thống.
Block Storage là gì?
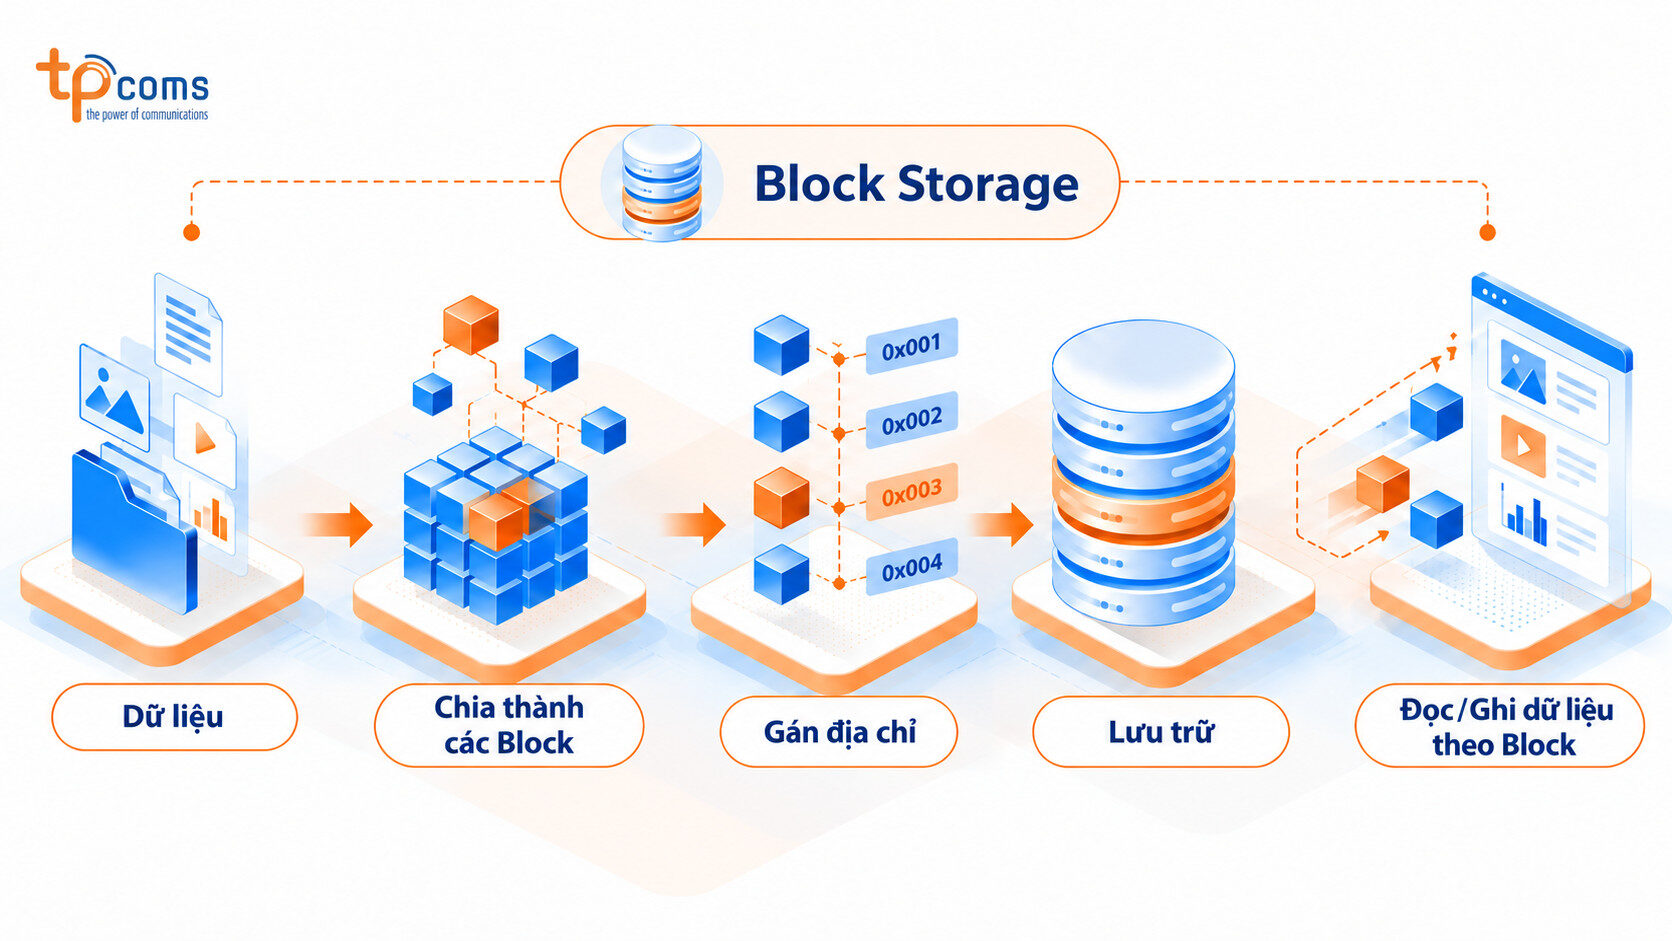
Block Storage tổ chức không gian lưu trữ thành các block có kích thước xác định, được hệ thống phân bổ để tạo thành vùng lưu trữ logic cho máy chủ. Khi được cung cấp dưới dạng volume hoặc block device, vùng lưu trữ này có thể được hệ điều hành nhận diện và sử dụng để thực hiện các thao tác đọc/ghi dữ liệu trực tiếp ở cấp block.
Dữ liệu được chia thành các Block như thế nào?
Khi máy chủ thực hiện thao tác đọc hoặc ghi dữ liệu, hệ điều hành sẽ gửi yêu cầu I/O đến vùng lưu trữ được cung cấp dưới dạng volume hoặc block device. Yêu cầu này xác định vị trí dữ liệu cần truy cập và lượng dữ liệu cần đọc hoặc ghi. Hệ thống Block Storage sau đó xử lý yêu cầu ở cấp block, xác định các block tương ứng trên vùng lưu trữ và thực hiện thao tác I/O trên hệ thống Storage.
Với cơ chế này, ứng dụng không cần quản lý trực tiếp cách dữ liệu được phân bổ trên thiết bị lưu trữ. Thay vào đó, hệ điều hành và lớp Storage phối hợp để xử lý việc ánh xạ yêu cầu I/O tới vùng dữ liệu tương ứng. Nhờ đó, Block Storage có thể cung cấp khả năng truy cập dữ liệu ở cấp block với độ trễ và hiệu năng I/O phù hợp cho các workload như máy chủ ảo, cơ sở dữ liệu hoặc hệ thống ứng dụng doanh nghiệp.
Volume trong Block Storage là gì?
Volume là một vùng lưu trữ logic được tạo trên hệ thống Block Storage và cung cấp cho máy chủ hoặc máy ảo dưới dạng một thiết bị lưu trữ, thường được hệ điều hành nhận diện tương tự một disk.
Sau khi được gắn vào máy chủ, Volume có thể được format và tạo Filesystem để phục vụ các nhu cầu như:
- Cài đặt hệ điều hành.
- Lưu trữ dữ liệu ứng dụng.
- Chạy cơ sở dữ liệu.
- Lưu trữ dữ liệu hoặc workload của máy ảo.
Trong môi trường ảo hóa, Block Storage cũng có thể được hypervisor sử dụng làm storage backend hoặc datastore để lưu trữ và vận hành các máy ảo. Đây là cách sử dụng khác với việc gắn trực tiếp một Block Volume vào từng máy ảo.
Do đó, cần phân biệt Block Storage, volume và filesystem:
- Block Storage: cung cấp không gian lưu trữ ở cấp block
- Volume: vùng lưu trữ logic được cấp cho máy chủ
- Filesystem: tổ chức Volume thành file, thư mục và các cấu trúc dữ liệu mà OS có thể sử dụng
Cơ chế hoạt động của Block Storage
-
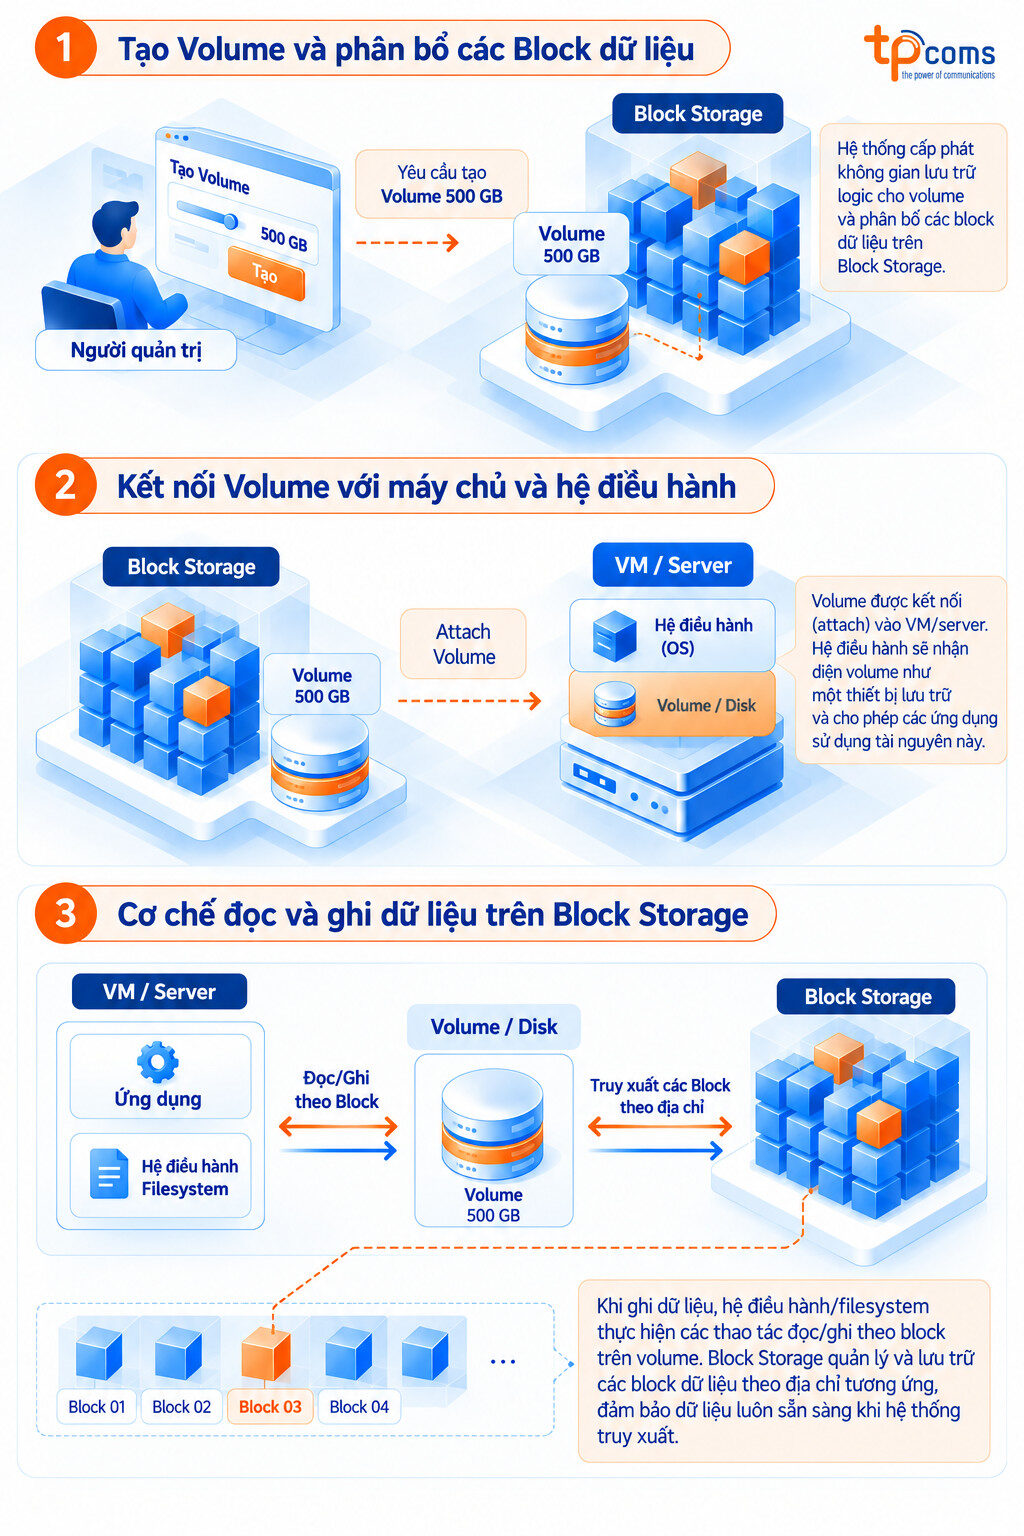
Tạo Volume và phân bổ các Block dữ liệu
Đầu tiên, người quản trị tạo volume và xác định dung lượng cần cấp cho máy chủ. Hệ thống Block Storage sẽ tạo không gian lưu trữ logic tương ứng cho volume này.
Khi dữ liệu được ghi vào volume, dữ liệu được xử lý thành các block và gắn với địa chỉ logic riêng. Hệ thống dựa vào các địa chỉ này để xác định vị trí và thực hiện thao tác đọc, ghi dữ liệu khi có yêu cầu.
-
Kết nối Volume với máy chủ và hệ điều hành
Sau khi volume được tạo, volume sẽ được attach hoặc kết nối tới VM/server thông qua giao thức và cơ chế truy cập mà hệ thống Storage hỗ trợ. Hệ điều hành sẽ nhận diện volume như một thiết bị lưu trữ và cho phép các ứng dụng sử dụng tài nguyên này.
Nếu cần lưu trữ file, hệ điều hành có thể tạo filesystem trên volume. Filesystem chịu trách nhiệm tổ chức dữ liệu thành file và thư mục, trong khi lớp Block Storage vẫn xử lý các yêu cầu ở cấp block bên dưới.
-
Cơ chế đọc và ghi dữ liệu trên Block Storage
Khi ứng dụng phát sinh yêu cầu đọc hoặc ghi, hệ điều hành sẽ chuyển yêu cầu I/O đến các địa chỉ block tương ứng trên volume.
- Read: Hệ thống xác định các block chứa dữ liệu cần đọc và trả dữ liệu về cho máy chủ.
- Write: Dữ liệu mới hoặc dữ liệu được cập nhật sẽ được ghi vào các block tương ứng trên volume. Phạm vi xử lý phụ thuộc vào lượng dữ liệu thay đổi và cơ chế của hệ thống Storage.
Tùy vào đặc điểm workload, các yêu cầu I/O có thể được thực hiện theo hai dạng phổ biến:
- Random I/O: truy cập các vị trí dữ liệu không liên tục, thường xuất hiện ở database hoặc các workload có nhiều thao tác đọc/ghi nhỏ.
- Sequential I/O: truy cập dữ liệu theo trình tự liên tiếp, thường phù hợp với các workload xử lý dữ liệu tuần tự hoặc truyền lượng dữ liệu lớn.
Đặc điểm và ứng dụng của Block Storage
Block Storage được sử dụng phổ biến cho các workload cần truy cập dữ liệu ở cấp block và có yêu cầu cụ thể về IOPS, Throughput hoặc Latency.
Hiệu năng I/O và khả năng đáp ứng Workload
Để đánh giá khả năng đáp ứng của một hệ thống Storage, doanh nghiệp thường xem xét ba metric chính:
- IOPS: số lượng thao tác I/O có thể xử lý trong một giây.
- Throughput: lượng dữ liệu có thể truyền trong một đơn vị thời gian.
- Latency: thời gian phản hồi của một yêu cầu I/O.
Tùy vào workload, doanh nghiệp có thể lựa chọn hoặc điều chỉnh cấu hình Storage để đáp ứng nhu cầu về IOPS, throughput và latency. Điều này đặc biệt quan trọng với các ứng dụng có tần suất đọc/ghi cao hoặc yêu cầu độ trễ ổn định.
Lưu trữ cho Virtual Machine và Application
Block Storage có thể được sử dụng để cung cấp storage cho Virtual Machine (VM) và các ứng dụng doanh nghiệp. Volume có thể đóng vai trò boot volume cho hệ điều hành hoặc data volume để lưu trữ dữ liệu ứng dụng.
Tùy nền tảng và mô hình triển khai, Block Volume có thể được quản lý độc lập với lifecycle của Compute/VM, cho phép dữ liệu tiếp tục được lưu giữ khi VM được thay đổi, thay thế hoặc xóa. Mô hình này phù hợp với các workload như Application Server, ERP, CRM và Database.
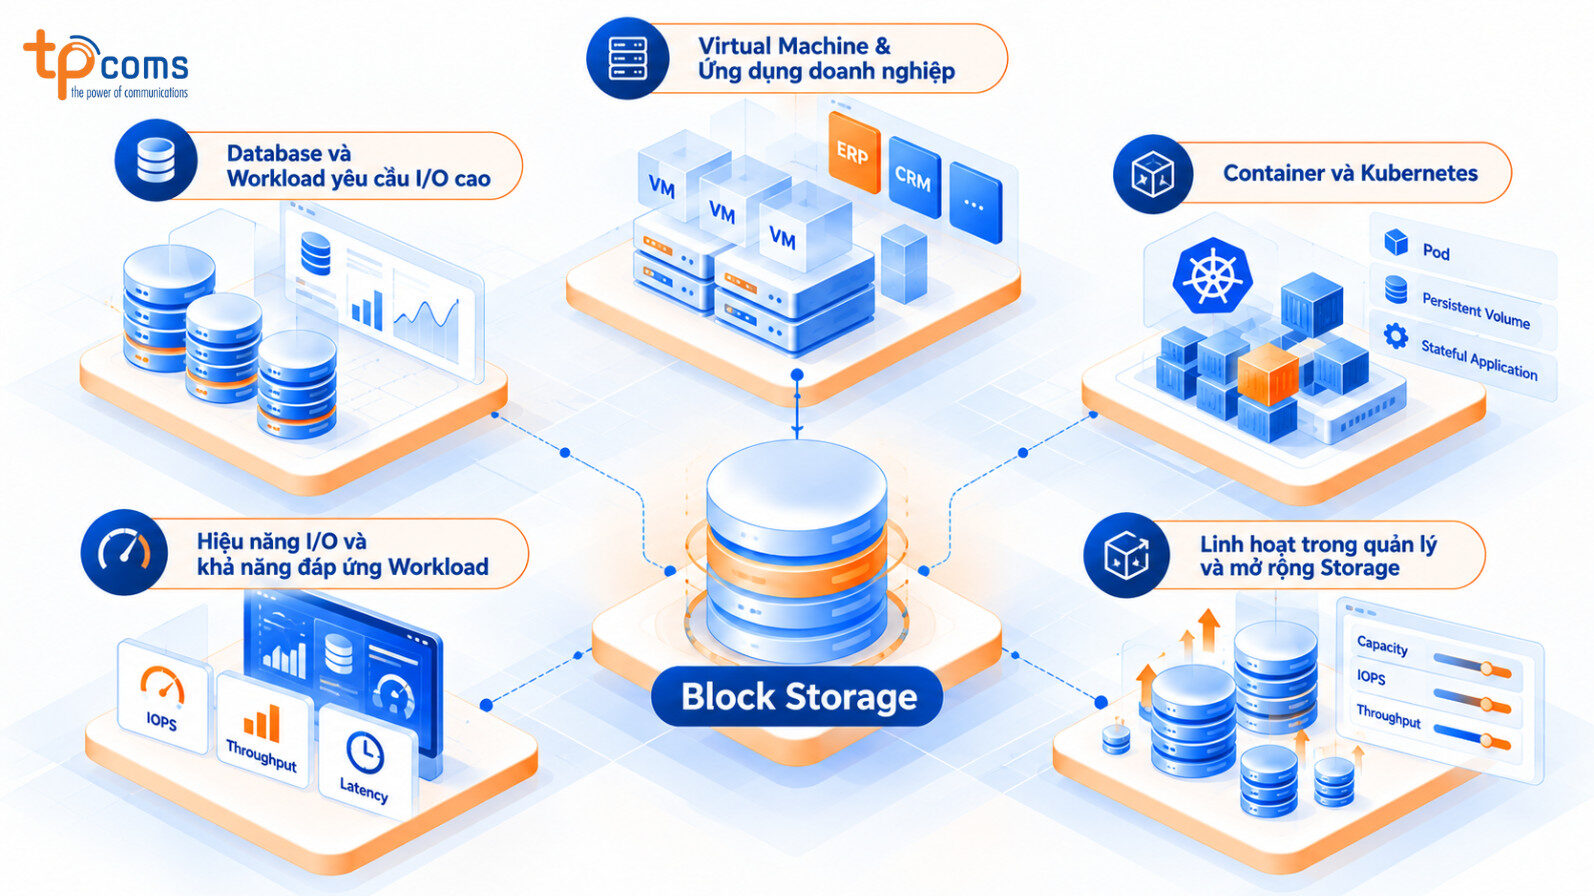
Database và Workload yêu cầu I/O cao
Block Storage thường được sử dụng với các hệ thống Database có tần suất giao dịch cao và thường xuyên phát sinh các thao tác đọc/ghi dữ liệu. Đặc biệt, các database có nhiều random read/write cần Storage đáp ứng tốt về IOPS và latency để duy trì hiệu năng xử lý truy vấn và giao dịch.
Ngoài Database, Block Storage , Block Storage có thể được sử dụng cho một số workload xử lý dữ liệu cần block-level access và có yêu cầu cụ thể về IOPS, Throughput hoặc Latency.
Container và Kubernetes
Trong môi trường Container và Kubernetes, Block Storage có thể được tích hợp thông qua cơ chế Storage của nền tảng và được cấp cho Stateful Workload dưới dạng Persistent Volume (PV). Dữ liệu trên Volume có thể được duy trì độc lập với vòng đời của từng Pod tùy theo cấu hình Storage.
Cách triển khai này đặc biệt phù hợp với Stateful Application như Database và các ứng dụng cần lưu trữ dữ liệu lâu dài trên Kubernetes. Storage được tách khỏi vòng đời của container, giúp dữ liệu không phụ thuộc hoàn toàn vào trạng thái của từng Pod.
Linh hoạt trong quản lý và mở rộng Storage
Block Storage cho phép doanh nghiệp tạo volume theo nhu cầu và lựa chọn dung lượng phù hợp với từng workload. Khi dữ liệu tăng, volume có thể được resize để mở rộng không gian lưu trữ mà không nhất thiết phải thay đổi toàn bộ kiến trúc ứng dụng.
Tùy nền tảng, doanh nghiệp cũng có thể điều chỉnh các thông số như capacity, IOPS và throughput để đáp ứng yêu cầu thực tế của workload. Trong môi trường Cloud, việc tách Storage khỏi tài nguyên compute còn giúp doanh nghiệp quản lý và mở rộng tài nguyên lưu trữ linh hoạt hơn, thay vì phải mở rộng đồng thời cả máy chủ và Storage.
Kết luận
Block Storage là một thành phần quan trọng trong hạ tầng lưu trữ hiện đại, đặc biệt khi doanh nghiệp cần xây dựng môi trường có khả năng mở rộng và đáp ứng nhiều yêu cầu lưu trữ khác nhau.
Do đó, khi triển khai Block Storage, doanh nghiệp cần đánh giá đặc điểm dữ liệu, mô hình I/O, yêu cầu hiệu năng trước khi lựa chọn cấu hình. Đây là cơ sở để xây dựng hệ thống lưu trữ vừa đáp ứng nhu cầu hiện tại, vừa có khả năng mở rộng khi workload phát triển.